A fronteira da IA está chegando na sua mesa
Duas semanas de lançamentos de IA e um padrão claro: modelos abertos encostando nos fechados, os fechados ficando mais baratos e modelos aprendendo a assistir vídeo de verdade.
Eu evito escrever post do tipo “isso muda tudo”. Na maioria das semanas, nada muda tudo.
Mas passei o fim de semana lendo os anúncios das últimas duas semanas e um padrão não parava de aparecer. Os melhores modelos estão ficando mais fáceis de ter na mão, mais baratos de alugar e melhores em entender imagem em movimento. Cada lançamento sozinho é só mais um lançamento. Juntos, eles dizem bastante sobre para onde isso está indo.
Vou resumir o que saiu e por que acho que importa.
Modelo aberto deixou de ser o “quebra-galho”
Durante um bom tempo, modelo aberto era o que você usava quando não dava pra pagar o melhor. Isso está ficando difícil de sustentar.
A Meta lançou o Muse Spark Open no dia 15 de outubro. É um modelo multimodal nativo, com 816B de parâmetros no total (42B ativos) e janela de contexto de 1M de tokens, feito para código e agentes. Os pesos estão no Hugging Face e nas grandes nuvens, e ele roda em vLLM, SGLang, llama.cpp, MLX e outros. O detalhe que me pegou: a Meta diz que é o primeiro modelo dessa categoria que roda num desktop, usando dois Mac Studio com M5 Ultra ligados juntos. Um porém: a licença é a “Muse Model License”, da própria Meta, com termos comerciais limitados. Não é Apache nem MIT. Leia antes de montar um negócio em cima.
A Reflection lançou o Beam, o primeiro modelo dela. É um mixture-of-experts de 501B com 23B ativos por token, contexto de 1M, entrada e saída só em texto, e licença Apache 2.0. Vem em BF16, FP8 e NVFP4, com suporte desde o primeiro dia em Transformers, vLLM e SGLang, além de um harness open source da própria Reflection.
A Mistral abriu o preview do Large 4 no dia 6 de outubro. É um modelo multimodal de 1 trilhão de parâmetros com 52B ativos, treinado do zero nos datacenters da própria Mistral na Europa. A API de preview já está no ar e a Mistral diz que os pesos saem até o fim do mês. E ela é bem direta num ponto: num teste em que o modelo precisa reproduzir uma vulnerabilidade real e depois corrigir, a Mistral diz que vários modelos fechados tiram quase zero porque se recusam a fazer a tarefa. Com pesos abertos, quem manda é a sua política, não a do fornecedor.
Você não precisa rodar um modelo de 800B em casa pra isso importar. O que importa é que “a gente hospeda o nosso” virou uma opção de verdade pra trabalho sério de código e agentes, e não um downgrade que você aceita pra economizar.
Os fechados responderam com preço
Os laboratórios fechados não ficaram parados. A briga deles foi mais no custo.
O Google lançou o Gemini 4 Argon no dia 13 de outubro. É o novo modelo de fronteira deles, com limite unificado de 1M de tokens entre entrada e saída, pensado pra trabalho longo e difícil em código, finanças, jurídico e ciência. O preço de lançamento é US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída, subindo pra US$ 4 e US$ 20 depois de 30 de novembro. O Google diz que o Argon ajudou os próprios times a aumentar em mais de 35% os envios de código feitos por agentes e a cortar quase um terço dos rollbacks. É o Google medindo o Google, então eu leio isso como direção, não como garantia pro meu código.
A Anthropic lançou o Claude Haiku 5.5 no dia 7 de outubro. É um modelo pequeno e rápido pra trabalho em volume, como resumos, classificação e subagentes, e a Anthropic diz que ele custa em média uns 75% menos que o Haiku 4.5. No mesmo anúncio, cortou pela metade o preço de leitura de cache do Sonnet 5.5, o que, segundo eles, deixa o modelo uns 20% mais barato na maior parte do trabalho com agentes.
A Meta também lançou o Muse Wonder no dia 12 de outubro, o modelo fechado de fronteira dela pra agentes de longa duração. Ele tem “Active Memory”, que guarda contexto entre conversas, “Active Focus”, pra seguir em frente quando trava, e API a US$ 4/US$ 20 por milhão de tokens.
Minha leitura: quando os abertos chegam tão perto, a vantagem dos fechados passa a ser preço, acabamento e ferramentas. Bom pra todo mundo que constrói em cima.
Os modelos estão aprendendo a assistir
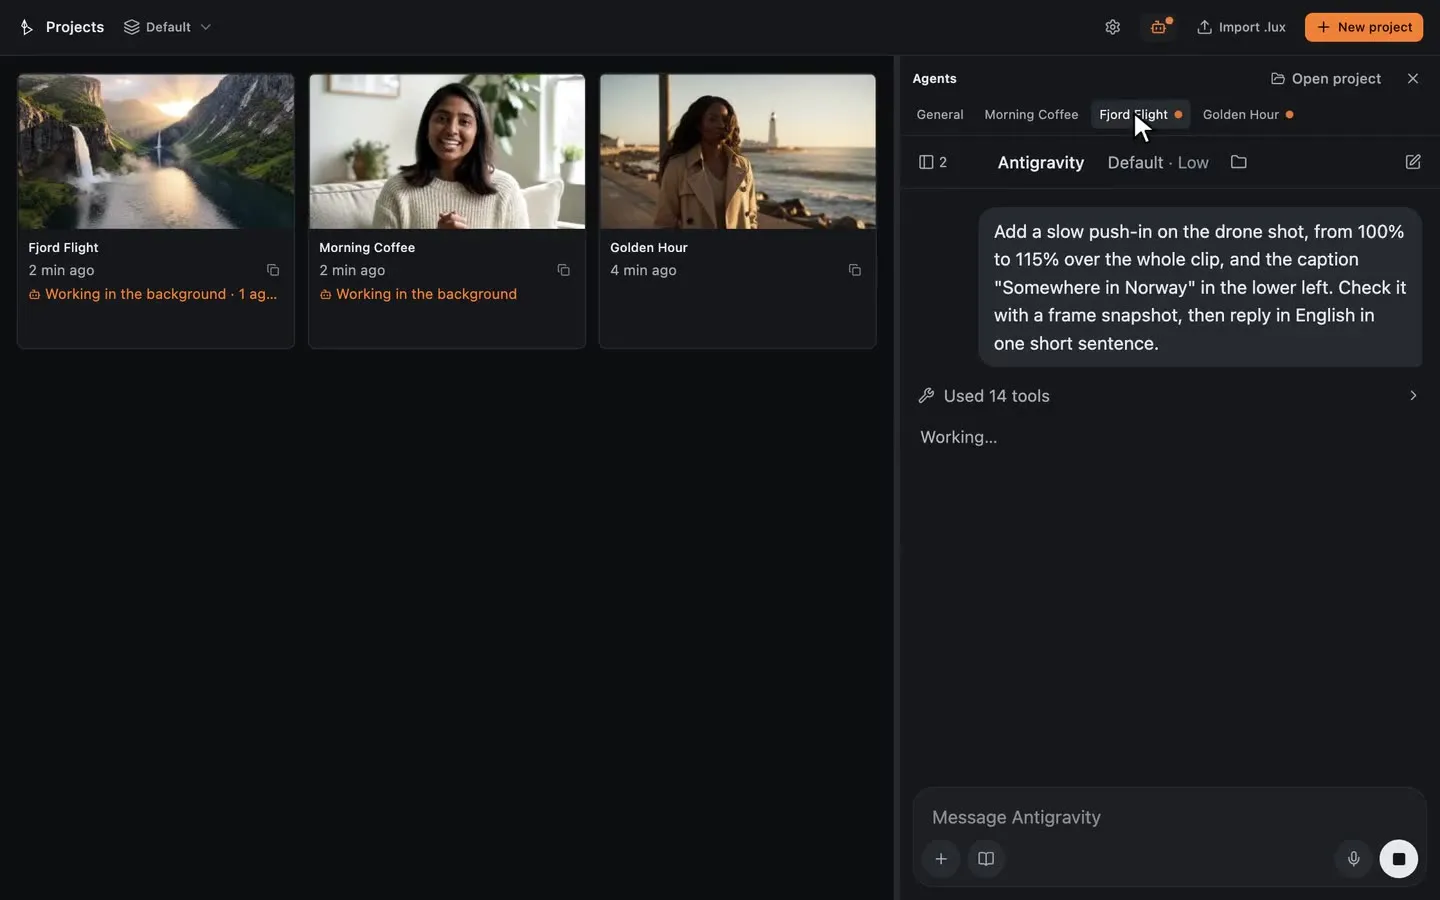
Essa é a parte que mais me interessa, porque eu faço um editor de vídeo.
A Elorian lançou o Glimpse no dia 16 de outubro. É um modelo de “pensamento visual” que volta pra imagem ou pro vídeo enquanto raciocina: recorta regiões, puxa frames específicos e roda código pra medir coisas. Custa US$ 0,60 por milhão de tokens de entrada. Pra ser justo com o hype: pela própria tabela da Elorian, ele ganha do GPT-6 Astra em quatro benchmarks, empata em um e perde nos outros, e ninguém independente rodou esses testes ainda. Mesmo assim, um time pequeno, fazendo pós-treino em cima de um modelo aberto e chegando nessa faixa, é um sinal forte.
E escondida no anúncio do Muse Spark Open tem uma frase que eu fico relendo. A Meta diz que testou o modelo rodando localmente, controlando o DaVinci Resolve de ponta a ponta, “revisando o material frame a frame pra achar os melhores momentos e recortar na vertical”.
É um modelo de pesos abertos, rodando numa mesa, editando vídeo num editor de verdade.
O que eu tiro disso
Três coisas.
- O modelo está virando peça trocável. Se um modelo de nível de fronteira pode ser aberto, barato ou local, dependendo da semana, apostar todo o seu fluxo num único fornecedor é a escolha mais arriscada. Monte as coisas de um jeito que dê pra trocar.
- O harness importa mais a cada mês. O Beam vem com harness próprio. As melhores demos do Argon são dentro do Antigravity. A melhor demo do Muse Spark Open é um modelo controlando um app de verdade. O valor está indo pra camada onde o modelo encosta nas ferramentas reais.
- Vídeo é o próximo. Texto e código ficaram bons primeiro. Modelos que acompanham movimento, escolhem momentos e mexem numa timeline estão chegando agora, e chegando baratos.
Transparência total: essa é a aposta por trás do que eu estou construindo. O Lugh Xtudio é um editor de vídeo onde você traz o seu próprio agente, e ele edita numa timeline de verdade que você ainda pode ajustar na mão. Então sim, eu sou suspeito. Mas escreveria esse post de qualquer jeito.
E você, está usando o quê hoje: aberto, fechado ou os dois? Fiquei curioso de verdade.
Fontes
- Meta, Introducing Muse Spark Open
- Hugging Face, Welcome Beam: a 501B open model you can own, customize, and scale e Reflection, Introducing Beam
- Mistral, Introducing Mistral Large 4
- Google, Gemini 4 Argon: Built to solve your hardest problems
- Anthropic, Introducing Claude Haiku 5.5
- Meta, Muse Wonder e preços
- Elorian, Introducing Glimpse, e The Terminal, Elorian Glimpse: price, benchmarks and what is unverified